

DNA-onderzoeken zijn onderdeel van bijna elk stamboekproces: van veulenregistratie en afstammingscontrole tot het vastleggen van genetische kenmerken. In de praktijk loopt het vaak stuk op versnippering: een deel in het systeem, een deel in Excel en de rest in mailboxen. Dat kost tijd en maakt statusbewaking onnodig ingewikkeld. Met Studbook Central beheer je DNA-onderzoeken op één plek.
In Studbook Central werk je met vaste onderzoeksregels per paard, duidelijke statussen en slimme logica voor STR/SNP. Zo houd je overzicht, voorkom je fouten en kan je team sneller door. Je team werkt met één werkwijze voor aanvragen, opvolging en afhandeling. Dat betekent minder handmatige controles, minder afhankelijkheid van Excel en vooral: meer grip op status en datakwaliteit.
In Studbook Central wordt elk DNA-onderzoek vastgelegd als een onderzoeksregel die aan een paard gekoppeld is. Meestal maakt het proces die regel automatisch aan, bijvoorbeeld tijdens veulenregistratie. Maar als er een specifieke aanleiding is (zoals een extra controle of een losse aanvraag), kan een medewerker ook handmatig een onderzoek starten door het paard en het gewenste onderzoek te selecteren.
Het voordeel van deze aanpak is dat je niet meer hoeft te zoeken naar de laatste stand van zaken. Openstaande en afgeronde onderzoeken zijn altijd terug te vinden in het paardendossier én in het DNA-overzicht.
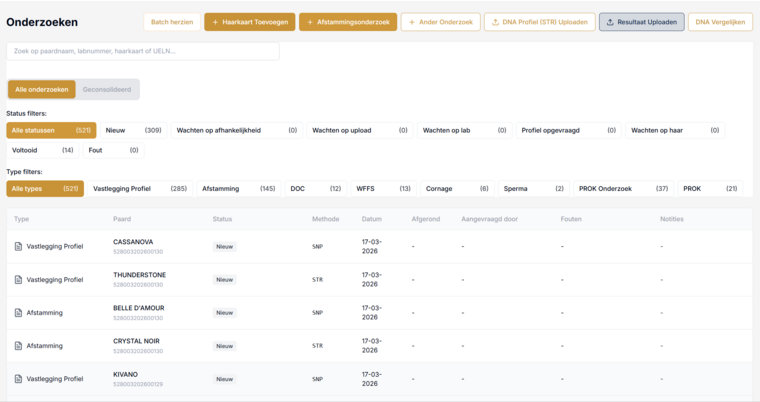
Bij afstammingsonderzoek wil je vooral zekerheid, zonder dat medewerkers telkens dezelfde afweging moeten maken. Studbook Central kijkt daarom niet alleen naar het veulen, maar ook naar de beschikbare onderzoeken van vader en moeder. Op basis daarvan bepaalt het systeem automatisch welke test(en) nodig zijn. In grote lijnen werkt het zo: als één van de ouders al een STR-onderzoek heeft, maakt Studbook Central zowel een STR- als een SNP-onderzoek aan. Als beide ouders geen STR hebben (of alleen SNP), dan is een SNP-onderzoek voldoende. Hiermee voorkom je onnodige tests én voorkom je dat je later moet bijsturen.
Naast afstamming worden DNA-onderzoeken ook ingezet voor gerichte aanvragen zoals DOC en WFFS. In Studbook Central vraag je deze onderzoeken aan als afzonderlijke onderzoeksregels. Daarna volgen ze dezelfde status- en opvolgingsstructuur als je andere DNA-onderzoeken, zodat je team niet hoeft te schakelen tussen verschillende werkwijzen.
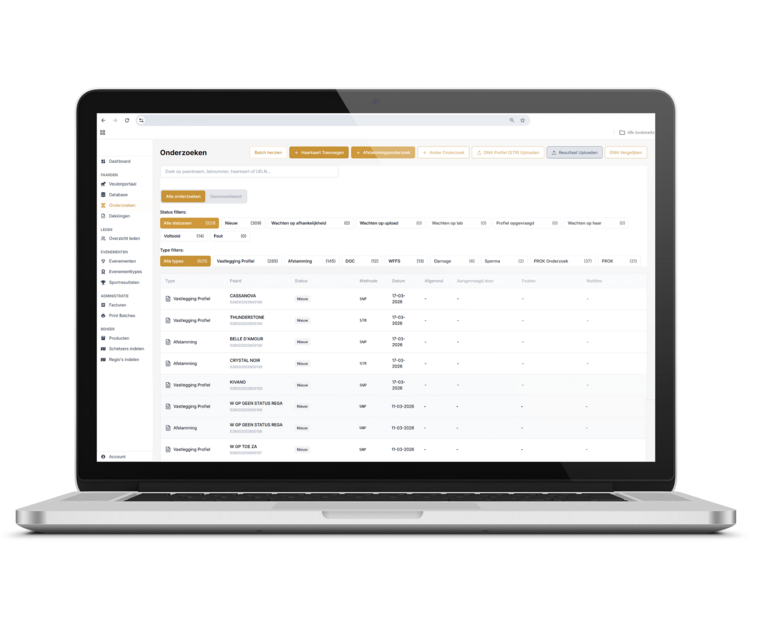
Alle DNA-onderzoeken worden per paard gebundeld in het DNA-portaal. Voor medewerkers die vooral voortgang willen bewaken is de weergave overzichtelijk en eenvoudig. Voor DNA-medewerkers is er juist extra detail beschikbaar, zodat werkzaamheden die nu vaak in Oxer en Excel gebeuren, ook in Studbook Central afgehandeld kunnen worden.
Omdat onderzoeken per paard gebundeld zijn, kun je bovendien instellen dat communicatie pas uitgaat wanneer alle openstaande regels voor dat paard zijn afgerond. Dat voorkomt losse updates en onnodige vragen.
Voor DNA-onderzoek is haar nodig. Als niet duidelijk is of er haar beschikbaar is, ondersteunt Studbook Central een vaste workflow met statussen en automatische e-mails. Het systeem kan een medewerker vragen het archief te controleren, waarna de onderzoeksregel op wacht op archief gaat. Is het haar niet te vinden, dan zet de medewerker de status op nieuw haar opvragen en worden consulent en eigenaar automatisch gemaild met het verzoek nieuw haar te trekken. Zodra die stap is afgerond, gaat de regel door naar wacht op consulent. Zo blijft het proces voorspelbaar en controleerbaar, zonder dat je een aparte opvolglijst hoeft bij te houden.
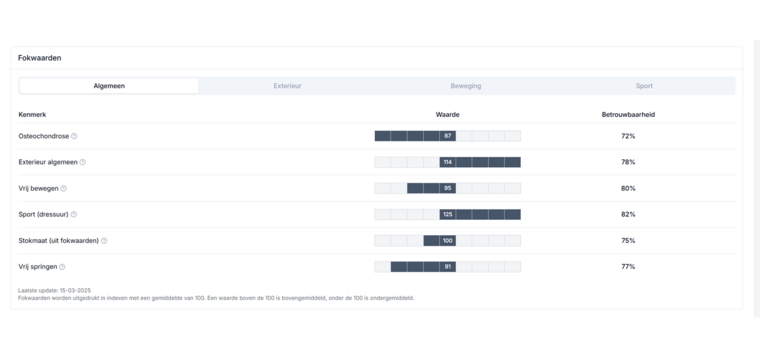
De verwerking van fokwaarden is in veel organisaties omslachtig. Studbook Central is ingericht op een efficiënter proces waarbij een medewerker het proces in het systeem start, waarna benodigde waardes worden opgehaald en gecommuniceerd. Als nieuwe fokwaarden terugkomen (bijvoorbeeld via een API), kunnen ze direct worden verwerkt en met historie onder het paard worden opgeslagen.